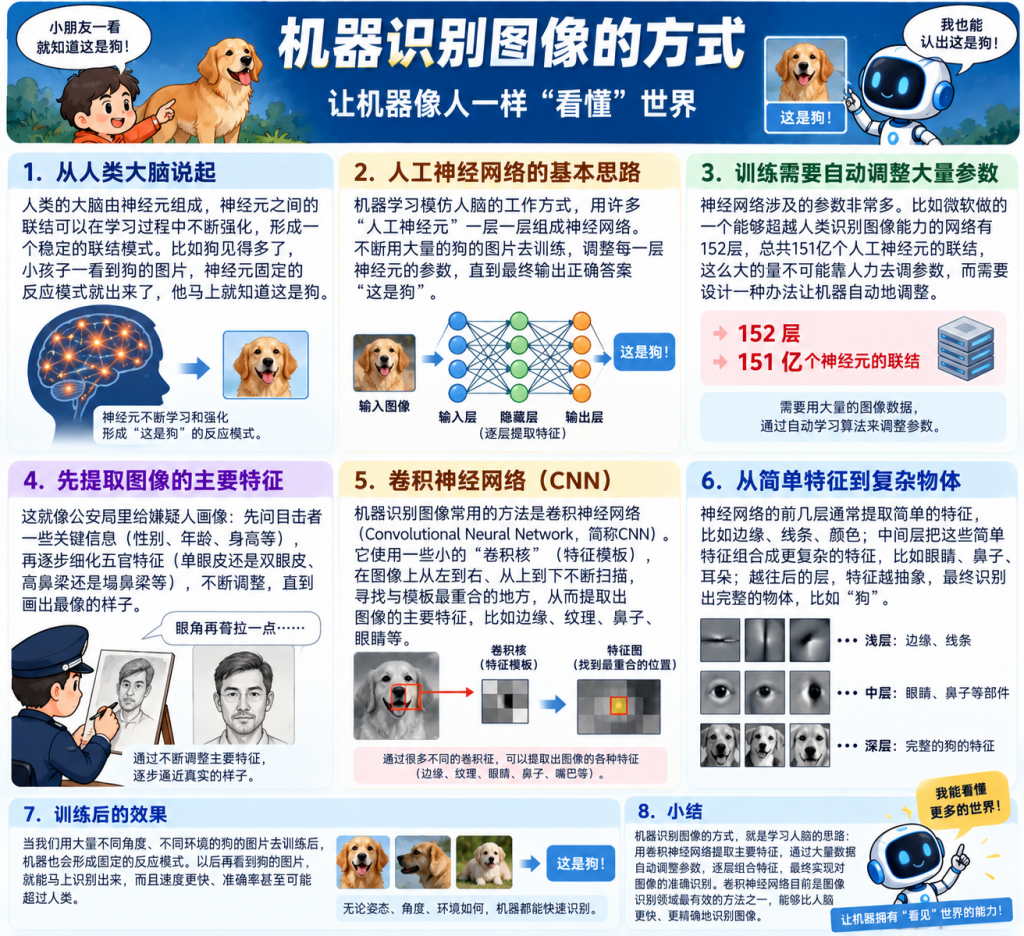
我们拿今天机器学习最拿手的模式识别来做个例子,具体看看机器认知是如何实现这一点的。图像的模式识别任务很明确。给一个小孩子看狗的图片,小孩子都知道这是狗。那么我们如何让机器看到狗的图片时也回应说这是狗?这就要学习大脑工作的方式。
人类的大脑是靠神经网络来工作的,神经元之间的联结可以在学习过程中被不断强化,形成一个稳定的联结模式。比如因为狗见得多了,小孩子一看到狗的图片,神经元固定的反应模式就出来了,他马上就知道这是狗。机器学习所依赖的人工神经网络也模仿这一点,用神经元一层一层地组成一个神经网络,不断地用狗的图片去训练机器,调整网络每一层神经元的参数,直到最终反应出正确答案说“这是狗”为止。久而久之,机器也形成了固定的反应模式,给出狗的图片就也能马上识别出来了。
问题是,神经网络涉及的参数太多。像微软做了个能够超越人类识别图像能力的网络就有152层,总共151亿个人工神经元的联结,这么大的量就不可能靠人力去调参数了,而需要设计一种办法让机器自动地调整。想想公安局里给嫌疑人画像都是怎么做的。画师会先问目击者嫌疑人的性别、年龄、身高等,然后问他五官的样子,比如是单眼皮还是双眼皮,是高鼻梁还是塌鼻梁等等。这就是提取主要特征,画师先画出样子,目击者说眼角再耷拉一点,画师再不断改,直到画出目击者记忆中的样子。
机器认知也学的是公安局这一招,就是提取主要特征。如何训练神经网络从人海里一眼认出嫌疑人?先给机器看嫌疑人的各种照片,也就是要先划定几个抓取五官主要特征的模板。比如鼻子,一开始就是随机画的图案,然后在要处理的图像上从左到右从上到下不断扫描,看能否发现重合的部分。如果发现不了就变一变这个图案,然后再扫,直到变得最像嫌疑人的鼻子,就是最重合的时候。这还只是鼻子,再把其他五官特征加上去,甚至机器还可以自己寻找出人类都感觉不到的特征,比如两眼的间距、口与鼻的距离等。把这些主要特征考虑得越充分,最后识别出来的结果就越准确。
机器这种学习公安局画像的方法,有一个专门的名词,叫卷积神经网络。所谓卷积,就是那些抓住主要特征的小模板,把图片上下左右横扫一遍,以求发现重合。这个名称很有些唬人,但它基本的工作方式通俗来说就是这样。机器学习当然还有很多其他的途径,但卷积神经网络目前是在图像识别里最火的方法,因为它非常有效,能够比人脑对图像的识别更快更精确。